Robots.txtは検索結果からページを消すための設定だと思っていませんか。実際にはクローラーの巡回を制御するファイルで、インデックスそのものを操作する機能はありません。この違いを取り違えると、消したいはずのページが残り続けたり、必要なページが検索されなくなったりします。まず押さえたいのは、できることとできないことの区別です。書き方の理解は、その前提を押さえてからで十分間に合います。
1. robots.txtとは?できることとできないこと
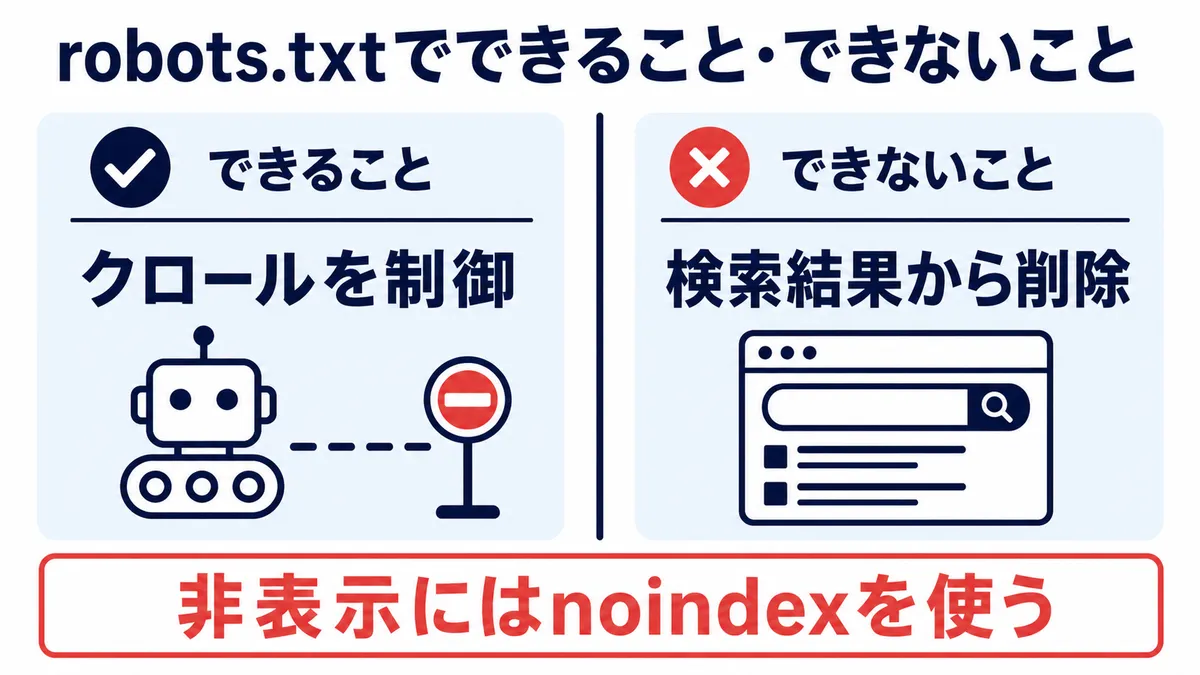
robots.txtはクローラーのアクセスを管理するファイルで、検索結果からページを削除する仕組みではありません。仕様と設置場所は、Google検索セントラル「robots.txtの概要」で確認できます。
robots.txtは、検索エンジンのクローラーに対して「どこを巡回してよいか」を伝えるファイルです。まず役割を正しく押さえると、書き方でつまずく場面が減ります。
1.1 robots.txtの役割と基本的な仕組み
結論として、robots.txtはクローラーの巡回を制御するファイルであり、インデックス(検索結果への登録)を制御するものではありません。クローラーはサイトを訪れると、最初にドメイン直下のrobots.txtを読み、指定に従って巡回範囲を判断します。
robots.txtが管理するのは「巡回するかどうか」だけで、「検索結果に載せるかどうか」ではありません。
この違いを最初に理解しておかないと、設定で意図と逆の結果を招きかねません。まず役割を押さえておくと、後の書き方も読み解きやすくなります。
1.2 robots.txtでできることとできないこと
robots.txtでできることは限られており、主に巡回の制御に関する範囲です。
- 特定のディレクトリの巡回拒否
- 特定のファイルの巡回拒否
- サイトマップの場所の通知
一方でできないことも明確です。すでに検索結果に表示されているページの削除、悪意のあるボットのブロック、インデックスの完全な拒否は、robots.txtの役割の外にあります。
削除やインデックス拒否を狙う場面では、robots.txtだけでは目的を果たせません。
できることとできないことを分けて捉えると、次に紹介する誤解を避けられます。
1.3 robots.txtでブロックしても検索結果に残る場合
結論から言うと、robots.txtで巡回を拒否したページでも、検索結果に表示される場合があります。外部の別サイトからそのURLへリンクが張られていると、クローラーはリンク経由でURLの存在を把握するためです。
ただしrobots.txtで本文を読めないため、内容が分からないままURLだけが登録されます。
巡回拒否は「中身を読ませない」設定であって、「検索結果に出さない」設定ではありません。
検索結果から確実に外したい場合は、robots.txtではなくnoindexを使います。この使い分けは第4章で詳しく整理します。
2. robots.txtの基本的な書き方
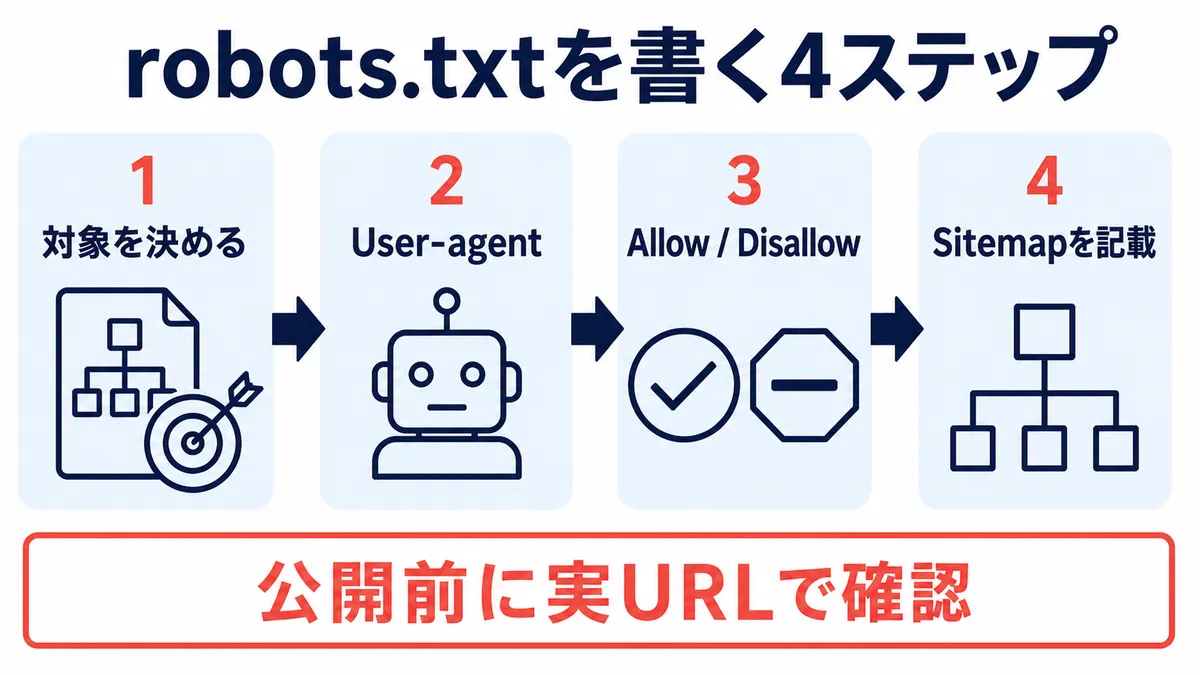
robots.txtは、4つの要素を組み合わせて記述します。User-agent、Disallow、Allow、Sitemapの役割を1つずつ確認します。
2.1 User-agentで対象クローラーを指定する
最初に書くのはUser-agentで、どのクローラーに向けた指定かを示します。すべてのクローラーを対象にする場合はアスタリスクを使います。
```
User-agent: *
Disallow: /private/
```
この例は、すべてのクローラーに対して/private/配下の巡回を拒否する指定です。GooglebotやBingbotなど特定のクローラーだけを対象にしたい場合は、アスタリスクの代わりにクローラー名を書きます。
対象を絞るか全体に適用するかは、このUser-agentの1行で決まります。
2.2 Disallowで巡回を拒否する
Disallowは、巡回を拒否するパスを指定する要素です。値を空にすると「拒否なし=すべて許可」を意味します。パスの指定では2つの記号が使えます。
- アスタリスク:任意の文字列に一致する
- ドル記号:URLの末尾に一致する
```
User-agent: *
Disallow: /tmp/
Disallow: /*.pdf$
```
上の例では、/tmp/配下の巡回を拒否し、さらに拡張子が.pdfで終わるURLをすべて拒否しています。
記号の意味を取り違えると想定より広い範囲を拒否するため、記述後に対象パスを見直します。
2.3 Allowで例外的に許可する
Allowは、Disallowで拒否した範囲の一部だけを例外的に許可する要素です。フォルダ全体は巡回させたくないが、その中の1ファイルだけは読ませたい場面で使います。
```
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
```
この例は、/wp-admin/配下を拒否しつつ、admin-ajax.phpだけを許可しています。指定が競合したときは、より具体的なパスの記述が優先されます。
DisallowとAllowを組み合わせると、拒否と許可を1段階細かく調整できます。
2.4 Sitemapでサイトマップの場所を伝える
Sitemapは、サイトマップXMLの場所をクローラーに伝える要素です。他の3要素と違い、特定のUser-agentに紐づかず、単独の行として記述します。
```
Sitemap: https://example.com/sitemap.xml
```
書き方の決まりとして、SitemapのURLは絶対パスで記載します。相対パスでは正しく読み取られないため、httpsから始まる完全なURLを書きます。
サイトマップの場所を伝えておくと、クローラーがサイト全体の構造を把握しやすくなります。
2.5 robots.txtの設置場所とファイル名の決まり
robots.txtは、置き場所とファイル名が厳密に決まっています。この2点を外すと、正しく書いても読み込まれません。
- 設置場所:ドメイン直下(例:example.com/robots.txt)
- ファイル名:小文字のrobots.txt固定
サブディレクトリに置いたり、ファイル名に大文字が混ざったりすると、クローラーは読みに来ません。
robots.txtは「ドメイン直下・小文字」でなければ機能しない前提を覚えておきます。
設置後は、ブラウザで実際のURLにアクセスして表示を確かめます。
公開・移行時の見落としを減らすには、サイトリニューアルのSEOチェックリストもあわせて確認しましょう。
3. robots.txtの設定でよくあるミスと防ぎ方
robots.txtは記述がシンプルなぶん、設定ミスの影響が大きく出ます。とくに起こりやすい4つを、防ぎ方とあわせて確認します。
設定ミスで意図どおりブロックできない例は、SNSでも指摘されています。
3.1 公開前にrobots.txtの全ブロックを解除し忘れる
最も重大なミスは、開発中に入れた全ブロックの記述を、公開時に外し忘れることです。開発環境では検索エンジンに見せないよう、次のような全体拒否を書く場合があります。
```
User-agent: *
Disallow: /
```
このDisallow: /はサイト全体の巡回を拒否する指定です。公開後もこの記述が残っていると、検索エンジンがサイトを一切巡回できず、検索流入が止まります。
公開作業のチェックリストに「Disallow: /の削除」を入れておくと、この事故を防げます。
3.2 CSSやJavaScriptをブロックしてしまう
表示に必要なCSSやJavaScriptのファイルを、robots.txtでブロックしてしまうミスもあります。管理用フォルダを拒否したつもりが、その中のデザインや動作に関わるファイルまで巻き込む場合があります。
クローラーがCSSやJavaScriptを読めないと、ページを実際の見た目どおりに評価できません。結果として、正しく作ったページが適切に評価されないおそれがあります。
表示に関わるファイルは拒否の対象から外し、管理用パスだけを狙って指定します。
3.3 robots.txtの設置場所やファイル名を間違える
設置場所とファイル名の誤りは、robots.txtが読まれない典型的な原因です。よくある間違いを具体的に挙げます。
- サブディレクトリ設置:/blog/robots.txtのような配置は無効
- 大文字混在:Robots.txtやROBOTS.TXTは読まれない
これらは記述内容が正しくても、ファイル自体が認識されないため、設定がまるごと無視されます。
「ドメイン直下」「すべて小文字」の2点を、設置直後に必ず確認します。
心配な場合は、ブラウザでURLを開いて中身が表示されるかを見ます。
3.4 noindexと併用してしまう
検索結果から消したい一心で、robots.txtでの巡回拒否とnoindexを同時に設定してしまうミスがあります。一見すると二重に対策していて安全に思えますが、実際は逆効果になりがちです。
robots.txtで巡回を拒否すると、クローラーはページに到達できず、ページ内のnoindexを読めません。その結果、消したいはずのページが検索結果に残る場合があります。
この併用は避けるべき組み合わせで、なぜ効かないのかは次章で詳しく扱います。
技術設定だけでなく記事と導線を整える考え方は、オウンドメディアのSEO運用方法で整理しています。
4. robots.txtとnoindexの使い分け
robots.txtとnoindexは似た目的で語られますが、制御している段階が違います。違いと正しい選び方を整理します。
4.1 robots.txtとnoindexの違いを整理する
両者の違いは、制御する対象が、クロールなのかインデックスなのかにあります。下の表で対比します。
| 比較軸 | robots.txt | noindex |
|---|---|---|
| 制御する段階 | クローラーの巡回 | 検索結果への登録 |
| 記述する場所 | ドメイン直下のファイル | 各ページのHTMLやHTTPヘッダー |
| 主な目的 | 巡回させたくない | 検索結果に出したくない |
| ページ内容 | 読まれない | 読まれる |
表のとおり、robots.txtは巡回の拒否、noindexはインデックスの拒否を担います。目的に合わせて選ぶ判断は、この違いが土台になります。
見せる前に止めるのがrobots.txt、見せたうえで載せないのがnoindexです。
4.2 robots.txtとnoindexを併用してはいけない理由
併用してはいけない理由は、robots.txtがnoindexの指示を読めなくするからです。クローラーは巡回を拒否されるとページに到達できず、ページ内に書いたnoindexにも気づけません。
その結果、インデックスから外したいページが検索結果に残ってしまいます。noindexが反映されない原因は複数あり、詳しい切り分けは別記事で解説しているため、ここでは併用を避ける点だけを押さえておきます。
消したいページほどブロックせず、クロールを許可するのが正しい使い分けです。
4.3 目的別の選び方
目的別の選び方は、次の2ステップで判断します。
- 巡回させたくないだけなら、robots.txtでDisallowを指定する
- 検索結果に出したくないなら、クロールを許可したうえでnoindexを設置する
判断の分かれ目は、「中身を読ませたくない」のか「検索結果に載せたくない」のかです。
検索結果からの削除が目的なら、robots.txtでブロックせずnoindexを選びます。
この順で考えると、2つの機能を取り違えずに設定できます。
なお、noindexを設定したのに検索結果から消えない場合は、このrobots.txtとの併用が原因になっていることが少なくありません。原因の切り分け方はnoindexが効かない原因を解説した記事で詳しく整理しています。
公開後の確認指標は、SEOのKPI設計と測定方法も参考になります。
5. robots.txtの設定後の確認方法
robots.txtは、設定して終わりではなく、意図どおり動いているかの確認まで必要です。3つの観点で点検します。
5.1 robots.txtが正しく置かれているか確認する
まず、ファイルが正しい場所に置かれているかを確認します。ブラウザのアドレス欄に、ドメイン直下のrobots.txtのURLを直接入力します。
- 入力するURL:https://(自社ドメイン)/robots.txt
- 確認すること:記述した内容がそのまま表示されるか
ページが表示されず404になる場合は、設置場所かファイル名が誤っています。
まずブラウザで直接開いて中身が見えるかどうかが、最初の確認ポイントです。
表示された内容が最新かどうかもあわせて見ます。
5.2 記述に誤りがないか確認する
次に、記述の中身に意図しない指定が混ざっていないかを確認します。とくに注意したいのは、必要なページまで拒否するDisallowが残っていないかです。
Disallow: /のような全体拒否や、公開したいディレクトリへの拒否指定が入っていないか、対象パスを1行ずつ見直します。
書いた本人が意図を覚えているうちに、Disallowの行を上から順に読み返します。
記述の誤りは、公開直後ほど見つけやすくなります。
5.3 robots.txtが意図どおり動いているか確認する
最後に、指定が実際に効いているかをツールで確認します。Google Search ConsoleのURL検査を使うと、対象URLがブロックされているかどうかを判定できます。
- URL検査:特定URLの巡回可否を確認する
- 反映時間:設定変更の反映には時間がかかる
設定を変えた直後は結果がすぐに反映されないため、時間をおいて再確認します。
変更後は「すぐに結果が出ない」前提で、日をあけて見直すと確実です。
巡回可否がツール上で意図どおりなら、設定は正しく機能しています。
SEO記事の企画・執筆・品質確認を支援するスマートSEO
スマートSEOは、700社以上を支援するSEO記事制作代行サービスです。1記事4,980円(税別)、月2〜100記事、8,000〜12,000文字を目安に、記事の企画・構成・執筆・品質確認を支援します。
AIで初稿を作成した後、SEO担当者が検索意図、事実関係、日本語表現、引用、リンク、CTAなど35項目を確認します。robots.txtやnoindex、リダイレクトなどサイト側の技術設定は記事制作と別の作業になるため、必要な場合は対応範囲を事前に確認してください。
\AIの速さとSEO担当者の品質を両立/
スマートSEOの料金・制作内容を見る6. robots.txtに関するよくある質問
robots.txtには、設置の要否や自動生成など、判断に迷う質問がつきものです。本文で触れきれなかった点を中心に答えます。
6.1 robots.txtは必ず設置しないといけませんか?
必須ではありません。robots.txtがなくても、クローラーはサイト全体を巡回できるため、サイトは問題なく検索対象になります。設置が有効なのは、特定のディレクトリやファイルの巡回を制御したい目的があるときです。制御したい対象がないなら、無理に置く必要はありません。逆に、巡回させたくない領域が明確にある場合は、設置する意味があります。
目的があるかどうかが、設置を判断する基準です。
6.2 WordPressではrobots.txtが自動でつくられますか?
WordPressでは、ファイルを自分で置かなくても、仮想のrobots.txtが自動で生成されます。これはサーバー上に実ファイルとして存在するのではなく、アクセス時に動的に出力されるものです。内容を変えたい場合は、ドメイン直下に実ファイルのrobots.txtを設置すると、自動生成の内容を上書きできます。プラグインから編集する方法もあります。
独自の指定をしたいときは、実ファイルを置いて上書きするのが基本です。
6.3 AIのクローラーもrobots.txtでブロックできますか?
記述としては指定できますが、確実にブロックできるとは限りません。User-agentにAIクローラーの名前を指定してDisallowを書けば、巡回拒否の意思は示せます。ただし、robots.txtに従うかどうかはクローラー側の任意です。
- 記述できること:User-agent指定での巡回拒否
- 限界:指示を無視するボットには効かない
ルールを守るクローラーには有効ですが、従わないボットは止められません。
robots.txtはあくまで「お願い」であり、強制力のある遮断手段ではありません。
従わないボットについて、SNS上でも次のような声が見られます。
7. まとめ:robots.txtは巡回とインデックスの制御を分けて使おう
robots.txtは、クローラーの巡回を制御するファイルであり、検索結果からページを消す機能はありません。できるのは、特定のディレクトリやファイルの巡回拒否と、サイトマップの場所の通知です。検索結果から外したい場合は、robots.txtでブロックせず、クロールを許可したうえでnoindexを設置します。
書き方はUser-agent、Disallow、Allow、Sitemapの4要素の組み合わせで、ファイルはドメイン直下に小文字のrobots.txtで置きます。公開前の全ブロック解除漏れや、noindexとの併用といったミスは、影響が大きいため設定後の確認まで行います。
巡回の制御とインデックスの制御は別物です。2つの役割を分けて考えれば、消したいページが残る事態も、必要なページが消える事態も防げます。まずは自社のrobots.txtをブラウザで開き、意図どおりの記述になっているかを確認するところから始めてください。
\月9,960円~プロのSEO対策/
スマートSEOのサービス内容を見る