FDEを目指したいものの、LLMの理論をどこまで学べば実務で通用するのか迷っていませんか。論文やモデル構造をすべて暗記することが出発点ではありません。
FDEに必要なのは、API連携、プロンプト設計、RAG、AIエージェントを顧客業務へ組み込み、本番で安全に動かす知識です。理論の深さより、業務課題に合わせて技術を選ぶ幅が問われます。
各技術の役割と、要件化から運用改善までの使い分けを押さえると、学ぶ順序が明確になります。ここではFDEの実務に直結するLLM知識を工程ごとに整理します。
\FDEの役割と仕事内容を確認できます/
1. FDEに求められるLLMの知識は理論より実装の幅
1.1 理論の深さより業務に載せるまでの実装力が問われる
FDEに最初に求められるのは、モデルの理論を掘り下げる力ではなく、業務に載せて動かすまでの実装力です。顧客ごとに扱う帳票も権限設計も既存システムも異なるため、一つの技術を研究者のように深く極めても、目の前の現場では使い切れない場合が多くなります。
たとえばLLMの内部構造を数式レベルで説明できても、社内の問い合わせ対応に組み込めなければ、業務は一歩も進みません。FDEの価値は、知識の深さではなく、動くものを現場に届けられるかで測られます。
そのため学習の優先順位も変わってきます。理論の完成度を上げる前に、まず小さくても動く仕組みを一つ作り切る経験を積むほうが、実務への距離は近くなるのです。
1.2 一つの技術を極めるより短期間で使える状態にする考え方
FDEの現場では、一つの技術を極めるより、幅広い技術を必要に応じて素早く実装へ落とし込む姿勢が問われます。生成AIの領域は進化が速く、半年単位で使える手法が入れ替わる場面もあるためです。
求められるのは、新しい手法が出たときに、その概要をつかんで自分の業務で試せる状態まで持っていく速さです。深さだけを追う学習は特定のモデルに依存しやすく、環境が変われば価値が下がりがちです。
必要なものを短期間で使える状態にする力が、変化の速い現場では効いてきます。幅を優先しておくと、未知の技術に出会っても、ゼロから学び直す負担を小さく抑えられます。
1.3 求人が実装経験を求める背景
こうした実装の幅が求められる背景は、採用の要件にも表れています。プロパゲートのFDE求人では、必須要件として生成AI・LLMを組み込んだアプリの試作・運用経験を挙げています。
求人票から読み取れる、重視されている経験は次のとおりです。
- 生成AI・LLMを組み込んだアプリの試作経験
- 試作したものを実際の運用へ移した経験
- 未知の技術へ短期間で適応した経験
理論の理解度を問う設問ではなく、動かした経験を軸に据えている点が特徴です。FDEに必要な力は技術・業務・対人の3層に分かれており、その全体像はFDEのスキルは技術・業務・対人の3層で整理しています。実装経験は、この技術層を支える土台になります。
2. FDEの実務で使うLLMの4つの技術
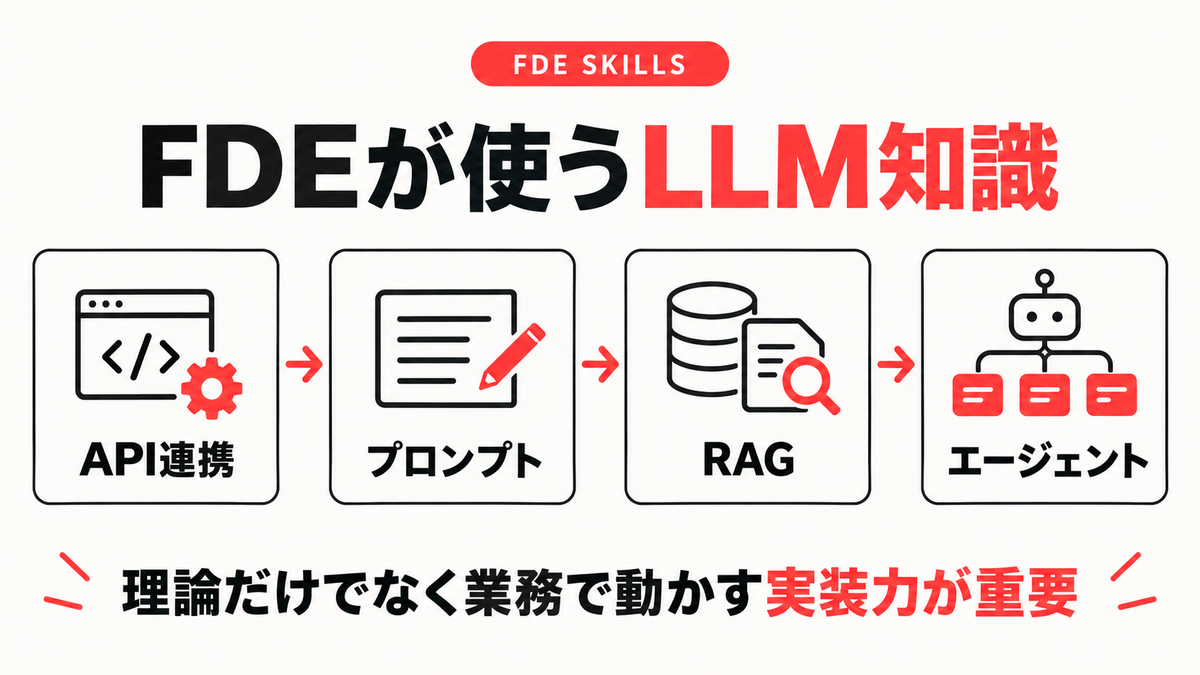
FDEが実務で使うLLM技術は、API呼び出し・プロンプト設計・RAG・エージェント設計の4つに集約されます。この4つを自分で組んで動かせるかが、実務の下限になります。
実際に手を動かす環境も押さえておくと、学ぶ順序を決めやすくなります。株式会社プロパゲートのFDEは、TypeScript / Python / React / Next.js / FastAPI / Supabase / LLM API / MCP / n8n / Vercel / GitHub といった構成で開発を進めています。特別な独自基盤ではなく、一般的なWeb開発の技術に生成AIを組み合わせる形です。
2.1 API呼び出しで既存モデルを業務に組み込む
FDEの実務で最初に触れるのが、LLM APIの呼び出しです。自前でモデルを持たなくても、APIを通じて既存モデルを自社業務に接続すれば、その日から使える機能を組み立てられます。
APIで実現できる代表的な用途は次のとおりです。
- 問い合わせメールの下書き生成
- 社内文書の要約
- 入力テキストの分類やタグ付け
LLMそのものの仕組みはLLMとはで確認できます。APIを自分で呼び出して結果を業務に返せることが、実務の最初の下限になります。まずは一つの用途で、呼び出しから出力までを通す経験が、その後の土台になります。
2.2 プロンプト設計で出力の精度と再現性を整える
次に効いてくるのが、プロンプト設計です。同じモデルでも、指示の書き方一つで出力の精度と再現性は大きく変わります。曖昧な指示のままでは担当者によって結果がぶれ、業務に組み込みにくくなります。
出力の形式や前提条件、禁止事項を明文化しておくと、誰が使っても近い結果が得られます。詳しい考え方はプロンプトエンジニアリングとはで解説しています。
プロンプト設計は、モデルを業務で安定して使うための調整弁です。精度が足りないときは、モデルを変える前に指示を見直すだけで解決する場面もあります。
2.3 RAGで社内データを回答に反映する仕組み
社内データを回答に反映させたいときに使うのが、RAG(検索拡張生成)です。モデルが学習していない自社固有の情報を、検索で補いながら回答させる仕組みになります。
RAGの基本的な流れは次の3段階です。
- 質問に関連する社内文書を検索する
- 検索で見つけた文書を回答の材料として渡す
- 渡した材料をもとに回答を生成する
この流れを組めれば、マニュアルや規定に沿った回答を返せます。詳細はRAGとはにまとまっています。社内データを扱う業務では、RAGを自分で組めるかが実装力の分かれ目になります。
2.4 エージェント設計で複数の処理を自動でつなぐ
複数の処理を自動でつなぎたいときは、エージェント設計が役立ちます。単発の回答で終わらせず、検索・判断・実行といった手順を連続してこなす仕組みです。
たとえば問い合わせ内容を分類し、必要な情報を検索し、返信案まで作る流れを一つにまとめられます。仕組みの基本はAIエージェントとはで解説しています。
外部ツールやデータと接続する方法はMCPとはで扱っています。エージェント設計まで組めると、単発の生成から業務フロー全体の自動化へ踏み込めます。ただし処理が増えるほど確認の手間も増えるため、小さな範囲から広げるほうが安定します。
3. モデルの学習や理論がFDEの守備範囲から外れる理由
FDEの守備範囲を見極めるには、どこからが機械学習エンジニアの領域かを知っておく必要があります。線引きが曖昧なままだと、必要のない学習に時間を使いかねません。
3.1 ファインチューニングや独自モデル構築が求められる場面
ファインチューニングや独自モデルの構築が必要になる場面は、実際には限られています。多くの業務は既存モデルの応用で足りるため、自前学習に踏み込むのは条件がそろったときだけです。
自前学習を検討する余地があるのは、次のような場合です。
- 既存モデルでは扱いきれない専門用語が多い
- 出力の形式や文体を厳密に固定したい
- 外部にデータを出せない制約が強い
これらに当てはまらなければ、まず検索やプロンプトで対応するほうが早く安く済みます。両者の違いはファインチューニングとRAGの違いで比較しています。自前学習は最後の選択肢であり、FDEが最初から抱える領域ではありません。
3.2 多くの業務はRAGとプロンプトで対応できる
実際の現場では、多くの業務がRAGとプロンプトの組み合わせで対応できます。既存モデルはすでに高い汎用性を持っており、そこに社内データと適切な指示を足すだけで、実用的な精度に届く場面が多いためです。
モデルを一から学習させるには、大量のデータと計算資源、そして継続的な保守が欠かせません。中小規模の業務では、その負担に見合う成果を出しにくいのが実情です。
足りない部分をモデルの改造で埋めるのではなく、検索と指示で補う発想が、FDEの標準的な進め方になります。この判断ができるだけでも、無駄な開発を避けられます。
3.3 機械学習エンジニアとの領域の線引き
FDEと機械学習エンジニアは、扱う対象が重なって見えても、担当範囲と目的が異なります。役割を混同すると、必要のない学習に時間を使いかねません。
両者の違いを、担当範囲・扱う技術・目的の観点で整理します。
この線引きを踏まえると、FDEが目指すべき学習範囲が見えてきます。モデルを作る側ではなく、モデルを業務に載せる側だと理解しておくと、学ぶべき順序を迷いにくくなります。
4. LLMの知識を顧客の業務に載せる工程
LLMの知識は、そのままでは業務に載りません。ここでは、知識を顧客の業務に合わせ込む工程と、学ぶ順序を具体的に見ていきます。知識をそのまま持ち込むだけでは足りず、この合わせ込みの部分こそが成果を左右する要になります。
4.1 知識だけでは業務が動かない理由
LLMの知識をそろえても、それだけで業務は動きません。実際の現場には、モデルの外側にある制約が数多く存在するからです。
業務に載せる際に必ずぶつかる制約は、次のような点です。
- 帳票やデータの形式が業務ごとに異なる
- 誰がどこまで閲覧・操作できるかの権限設計
- 既存システムとの連携やデータの受け渡し
これらはモデルの性能とは別の問題で、合わせ込みができて初めて業務は回り始めます。LLMの知識は出発点にすぎず、業務の制約に合わせる工程がなければ成果につながりません。
4.2 現場に合わせ込む工程で差がつくポイント
この合わせ込みの工程こそ、FDEの実力差が最も出る部分です。帳票の細かな項目、部署ごとの権限、既存システムの癖といった条件は、技術書には書かれていません。
現場ごとに事情が違うため、正解を一般化できないのが難しさです。同じ要約機能でも、経理部と営業部では求める粒度も出力形式も変わってきます。
この領域は技術書では学べず、現場に入って初めて身につきます。だからこそ、知識を持つ人が増えても、実際に動かせる人は限られるのです。
4.3 まず業務を一つ自動化する学ぶ順序
学ぶ順序に迷ったら、まず自分の身近な業務を一つ自動化してみるのが近道です。プロパゲートのFDEは、次の6段階で業務にAIを載せています。
- 現場を理解し、業務の流れをつかむ
- 業務を構造化して整理する
- AIと人の役割を設計する
- 実データで試作して検証する
- 本番環境へ導入する
- 数字で効果を測り改善する
この流れを小さな業務で一周してみると、知識が実装につながる感覚がつかめます。未経験からの進み方は非エンジニアからFDEを目指す方法で紹介しています。
業務そのものを整理する視点は業務可視化とはが参考になります。知識を先に詰め込むより、一つの業務を最後まで動かす経験が力になります。
5. プロパゲートのFDEとAI導入支援の取り組み
ここまで見てきた実装の幅を、実際の業務でどう形にするか。プロパゲートのFDEとAI導入支援の進め方から、具体的なイメージを整理します。
5.1 どんな課題を持つ人・企業に向いているか
プロパゲートのFDEとAI導入支援は、AIを試したいが自社だけでは実装まで進められない企業や、実装を通じてFDEの力をつけたい人に向いています。知識はあっても、業務に載せる工程で止まってしまう場合が多いためです。
次のような課題を持つ方に適しています。
- 生成AIを業務に組み込みたいが着手できていない企業
- 過去にツールを導入したが定着しなかった現場
- 実装経験を積んでFDEを目指したい個人
こうした状況では、知識の量よりも、現場に合わせて動かす伴走が効いてきます。プロパゲートのFDE職紹介ページは、業務の理解から実装までを一つの流れで支えます。
5.2 現場理解から本番導入まで一貫して担う体制
プロパゲートのFDEは、現場理解から本番導入までを一貫して担います。要件だけ受け取って納品する形ではなく、業務の中に入り、6段階の工程を顧客と一緒に進めていく体制です。
社内に専任の担当を置けない企業でも、現場の理解から役割設計、試作、導入、数字での改善までを外部に委ねられます。導入して終わりではなく、効果を測りながら改善まで伴走するため、定着しないまま放置される事態を避けやすくなります。
FDEが現場でどう動くかはプロパゲートのFDE職紹介ページにまとめています。知識を持ち込むだけでなく、業務が実際に回るところまで見届ける点が、この体制の軸です。
5.3 未経験からFDEを目指す際の補足
未経験からFDEを目指す場合も、いきなり高度な理論から入る必要はありません。まずは身近な業務を一つ自動化し、試作と運用の経験を積むところから始められます。
SNS上には、FDEをキャリアの選択肢として捉える声もあります。
実装の幅は、小さな成功と修正を繰り返すなかで広がっていきます。検討のハードルを感じる方も、求人要件や仕事内容を先に確認しておくと、必要な経験の輪郭がつかめます。
募集の詳細はFDEの求人ページで確認できます。未経験でも、動かした経験を積み重ねれば実務レベルに近づけます。
\4つのFDEポジションを募集中です/
6. FDEのLLM知識に関するよくある質問
FDEのLLM知識について、学び始める前につまずきやすい疑問を整理します。ここまでの内容を、必要な範囲と学ぶ順序の観点から短くまとめ直します。判断に迷ったときの目安として活用してください。
6.1 FDEに機械学習の知識はどこまで必要ですか?
結論として、FDEに機械学習の深い知識は必須ではありません。多くの業務は既存モデルの応用で足りるため、必要な範囲と不要な範囲を分けて考えると迷いません。
- 必要:APIやRAG、プロンプトで既存モデルを使う知識
- ほぼ不要:モデルを一から学習させる理論
- 状況次第:ファインチューニングの判断材料となる基礎
自前学習が必要になる場面は限られます。まずは既存モデルを業務で動かす力を優先すると、実務に早く近づけます。
6.2 FDEを目指すならどの言語から学べばよいですか?
最初の一歩としては、LLMのAPIを扱いやすい言語から始めるのが現実的です。特定の言語を完璧にする前に、APIを呼び出して出力を業務に返す流れを一度通すことを優先します。
言語そのものより、呼び出し・プロンプト・検索の一連を自分で動かせるかが実務の入り口になります。学び始めは、身近な業務を一つ自動化する題材を決めると、必要な範囲だけを効率よく習得できます。
6.3 LLMの知識は独学でも実務レベルに届きますか?
独学で届く範囲と、現場でしか身につかない範囲を分けて考えるのが答えです。API・プロンプト・RAG・エージェントの基本は、独学でも十分に習得できます。
一方、帳票の形式や権限、既存システムの制約に合わせ込む工程は、実際の業務に入って初めて身につきます。独学で土台を作り、現場で経験を重ねる進め方が近道になります。
7. まとめ:FDEのLLM知識は深さより業務に載せる幅で身につけよう
FDEに求められるLLMの知識は、理論の深さではなく、業務に載せて動かす幅にあります。API・プロンプト・RAG・エージェントの4つを自分で組めれば、多くの業務は既存モデルの応用で対応できます。
モデルの学習や論文レベルの理論は、機械学習エンジニアの領域です。FDEはその手前で、知識を顧客の業務に合わせ込む工程に力を注ぐと、成果に直結します。
学び始めるなら、まず身近な業務を一つ選び、現場理解から改善までを小さく一周してみてください。動かした経験の積み重ねが、変化の速い現場で通用する実装力につながります。
仕事内容はプロパゲートのFDE職紹介ページ、現在の募集条件はプロパゲートの求人一覧で確認できます。
\FDEの仕事内容と募集条件を確認/